

Empecemos por el principio. Por el principio de todo:
“Novio mío, querido de mi corazón,
grande es tu hermosura, dulce como la miel.”
Con bastante consenso, estos versos abren el poema de amor más antiguo que se conserva. El poema a Shu-Sin (Sumeria, ca. 2000 a. C.), escrito sobre una tablilla de arcilla como parte de un ritual en el que una sacerdotisa declaraba su amor al rey. Cuatro mil años después seguimos escribiendo, más o menos, sobre lo mismo.
Sin embargo, hubo que esperar hasta 1952 para que lo escribiera una máquina. Ese año, en Manchester, Christopher Strachey programó el Ferranti Mark I (unos de los primeros ordenadores comerciales) para generar cartas de amor. El resultado es la primera declaración romántica firmada por un computador.

El algoritmo de Strachey no modelaba la escritura como un proceso creativo, sino como una plantilla que se rellena. Es decir, plantea su composición como un procedimiento mecánico y bastante predecible, basado en fórmulas prefijadas. Resulta curioso que, aunque entre las palabras disponibles figuraban varias formas relacionadas con el término “amor”, ninguna acabó figurando en las cartas generadas mediante este procedimiento que alcanzaron mayor difusión. El lector que quiera profundizar más sobre este fascinante tema puede consultar Link (2006).
A partir de ahí, la historia se acelera. En 1959, Theo Lutz escribió sus Stochastische Texte en un Zuse Z22 combinando mediante reglas probabilísticas el vocabulario de El castillo de Kafka. De esta forma produjo la primera poesía computacional jamás “creada”. La poesía computacional posterior empezaría a incorporar restricciones estilísticas, métricas, rima, etc. Hoy los grandes modelos de lenguaje han cambiado por completo el paradigma. Para ellos, crear es predecir: elegir palabra a palabra una continuación verosímil de la secuencia anterior. Funciona asombrosamente bien, pero plantea un inconveniente que suele pasar inadvertido. Un modelo de lenguaje no sabe contar sílabas, no sabe rimar, simplemente genera y, si acaso, comprueba después. Cuando falla, y desde luego falla, no hay forma de explicar por qué ni de garantizar que no vuelva a fallar. Es un defecto inherente, fruto de su entrenamiento.
Poco después, en noviembre de 1960, sin precisar ordenadores, el escritor Raymond Queneau y el matemático François Le Lionnais fundaron en París el OuLiPo (Ouvroir de Littérature Potentielle, “Taller de Literatura Potencial”). Se trataba de un conjunto de escritores y matemáticos agrupados en torno a una idea provocadora. Según ellos la libertad absoluta no permitía producir buena literatura y la única manera de innovar realmente pasaba por imponerse reglas artificiales, difíciles y explícitas. En palabras de los propios oulipianos, eran “ratas que construían ellas mismas el laberinto del que pretendían escapar”.
Esas reglas fueron denominadas contraintes, “constricciones” (o restricciones). Pueden ser lingüísticas (una letra, un fonema, una palabra prohibida) o directamente matemáticas: una ecuación, una permutación, un algoritmo. Entre los ejemplos más conocidos se cuenta La disparition (1969), de Georges Perec, una novela de más de trescientas páginas en la que no se utiliza ni una sola vez la letra “e”, la más frecuente del francés. En términos matemáticos, se trata de escribir sobre un alfabeto al que se le ha quitado un elemento. En La Vie mode d’emploi (1978) del mismo autor, la “Vida sin instrucciones de uso” en español, un edificio parisino de 10 × 10 habitaciones sirve como tablero de un complejo juego: el narrador lo recorre siguiendo el salto del caballo del ajedrez, mientras que la distribución de los objetos, los personajes y los motivos de cada capítulo está regida por un cuadrado grecolatino de orden 10.
No obstante, ningún ejemplo ilustra mejor esta relación entre literatura y matemáticas que Cent mille milliards de poèmes (1961), los “Cien mil millardos de poemas” de Queneau. El libro contiene diez sonetos impresos en páginas cortadas en catorce tiras horizontales, una por cada verso. Todos los sonetos comparten la misma estructura sintáctica y el mismo esquema de rima, de modo que el primer verso de cualquiera de ellos puede combinarse con el segundo de cualquiera de los otros, y así sucesivamente. Hay, por tanto, diez posibilidades para cada una de las catorce posiciones: en total, 1014 sonetos diferentes, cien billones de poemas posibles a partir de solo ciento cuarenta versos. Queneau había convertido así un libro de poesía en una auténtica máquina combinatoria: el lector no recibe un poema terminado, sino un espacio de posibilidades que puede recorrer mediante distintas conjugaciones. El propio Queneau calculó que, leyendo un poema por minuto durante las veinticuatro horas del día, harían falta unos doscientos millones de años para leerlos todos.
Combinatoria, restricciones (o constricciones)… Cualquier lector o lectora asiduo de esta sección de Muy Interesante de la SEIO habrá reconocido ya el terreno de juego.
¿Y si optimizamos?
Y sin embargo falta algo. En los Cent mille milliards hay cien billones de sonetos formalmente correctos y ni un solo criterio para preferir uno a otro. La constricción define qué es admisible, no determina qué es mejor. Ese hueco tiene nombre en matemáticas. Es la diferencia entre un problema de factibilidad y un problema de optimización.
Un problema de optimización combinatoria tiene siempre tres ingredientes: 1) unas variables de decisión, que codifican lo que hay que elegir; 2) unas restricciones, que separan lo admisible de lo inadmisible (esas constricciones); y 3) una función objetivo, un número que mide la calidad de cada solución y que queremos hacer lo mayor (o lo menor) posible. Con estos tres ingredientes se pueden, por ejemplo, planificar rutas de reparto tratando de evitar la envidia entre conductores o buscando soluciones más equitativas, véanse Ljubić et al. (2026a) o Ljubić et al. (2026b); extraer conclusiones ocultas en encuestas modelizadas como hipergrafos, véase Benati et al. (2025); o calcular estimadores estadísticos especialmente robustos, como en Puerto y Torrejon (2025), por citar algunos problemas en los que los autores de este artículo han trabajado tenazmente.
La pregunta que guía este artículo es, con estos antecedentes, muy concreta:
Dado un conjunto suficientemente extenso de versos, ¿podemos seleccionarlos de forma que compongan un poema con una estructura fija (métrica y rima) y que, además, sea el mejor posible conforme a algún criterio?
Formulada de esta manera, se delinea claramente como un problema de optimización combinatoria. Hay decisiones (qué verso ocupa cada posición), hay restricciones (medir ocho sílabas, rimar donde toca, no repetir palabra en rima) y hay un objetivo que guía dicha decisión de elección de los versos, el cual discutiremos al final porque es, con diferencia, la parte más resbaladiza.
La ventaja frente al “generar y filtrar” de los modelos de lenguaje es que, en nuestro caso, cualquier solución admisible del modelo es un poema formalmente correcto en su construcción. No hay que descartar candidatos, porque los incorrectos no llegan a existir. Y si el algoritmo de resolución termina, no devuelve solo un poema, sino un certificado matemático de que, en ese corpus y con ese criterio, no hay ninguno mejor.
Pero, antes de aplicarnos a ello, hay varias cosas que debemos dilucidar. Por ejemplo, un ordenador, ¿puede inventarse frases con una determinada estructura? ¿Sabe qué es una sílaba? ¿Y una rima? Veámoslo.
El andamio: por qué un romance
Elegimos el romance, el metro castellano por excelencia. Nació en la Edad Media y circulaban oralmente, recitados tanto por el pueblo llano como por los juglares. Formalmente los romances son series de versos octosílabos en los que los pares riman en asonante, es decir, coincidiendo solo las vocales a partir de la última acentuada, mientras que los impares quedan sueltos. Es la forma del Romancero viejo, poemas anónimos de época medieval y principios del Renacimiento que permanecieron durante siglos en la memoria colectiva, pero también la del romancero culto, sofisticado en las hábiles manos de Lope de Vega y Luis de Góngora y cultivado hasta nuestros días, con frutos tan destacables como el Romancero gitano de Federico García Lorca.
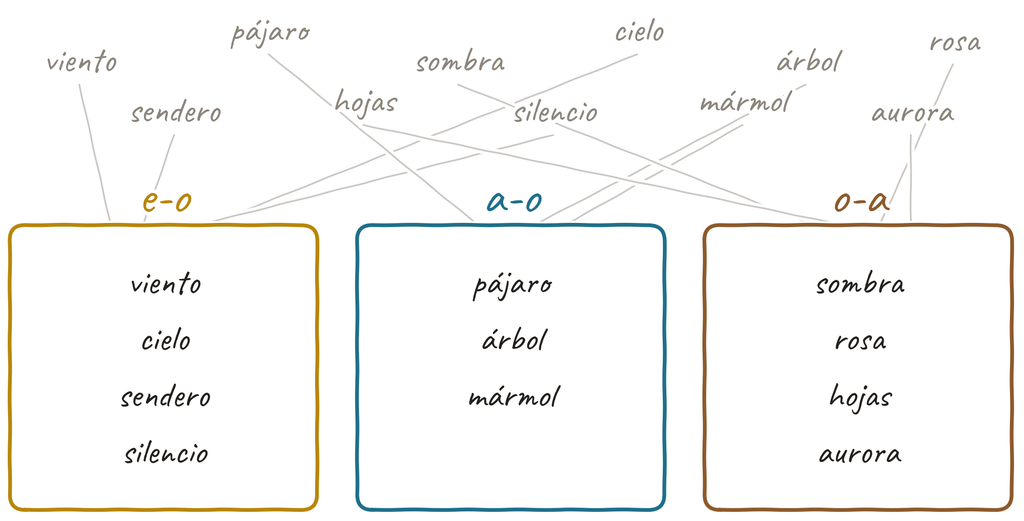
La elección no es sentimental, es matemática. En la rima consonante coinciden todos los sonidos finales, como en amor y dolor, y eso la vuelve exigentísima, porque cada clase de rima contiene poquísimas palabras. La asonante es mucho más laxa. Viento, cielo, pleito, sendero y silencio pertenecen todas a la misma clase, la e-o. Para un poema largo hacen falta muchas palabras finales distintas que rimen entre sí, y solo la asonancia las proporciona. Que la tradición oral española fijase el romance en asonante no es un capricho estético. Es la única elección que hace el problema resoluble cuando el poema crece. La métrica popular descubrió la factibilidad seis siglos antes de que existiera como concepto.

Los ladrillos: de dónde salen los versos
Un modelo de elección solo puede elegir entre lo que se le da (es complejo elegir sin tener base para hacerlo). Todo depende, por tanto, de un corpus. Los algoritmos de lenguaje aprenden sobre grandes conjuntos de texto, de los que infieren patrones que luego reproducen: ya sea una biblioteca entera o las conversaciones de WhatsApp que mantenemos a diario.
Para nuestro experimento necesitábamos miles de octosílabos correctos, variados y bien repartidos entre las clases de rima, quizás lo más difícil de asegurar. De nada sirve un corpus enorme si ninguna clase reúne suficientes finales distintos. Además, el español es un lenguaje con una mayor proporción de palabras llanas respecto a las agudas o esdrújulas, por lo que podríamos encontrarnos el problema de tener clases de rimas “à-a” (canta, casa, rama) o “í-o” (dolido, camino, suspiro) con representación suficiente, pero ninguna del tipo “ó” (amor, corazón, canción) o “á-a-o” (pájaro, cántaro, páramo). Por eso decidimos construir nuestro propio corpus, y lo hicimos por dos vías.
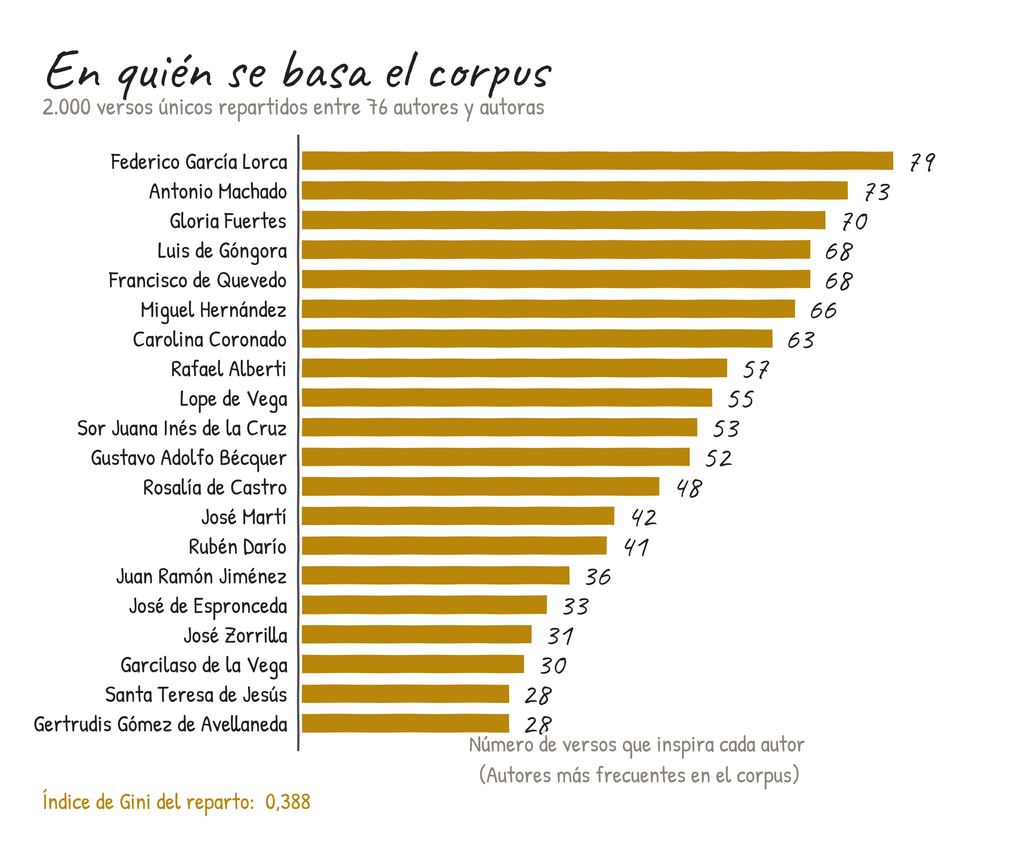
La primera aportó unos 2000 versos inspirados en la tradición. Partimos de una selección de los versos más celebrados de la poesía en español, obtenidos consultando webs y modelos de inteligencia artificial. En el caso de estos últimos, al tratarse de extractos de obras, no encontramos problemas de derechos de autor. Como muchos eran endecasílabos, los ajustamos a la medida de ocho sílabas. Así, por ejemplo, “Caminante no hay camino” entró como verso candidato directamente, pero “Se equivocó la paloma, se equivocaba” entró modificado como “Se equivocó la paloma”. La siguiente figura muestra qué autores y autoras acabaron pesando más en el resultado.
La segunda vía aportó unos 4000 versos generados desde cero mediante una gramática de adjunción de árboles (Joshi y Schabes 1997), LTAG por sus siglas en inglés. Y conviene desdramatizar el nombre pues, en esencia, no es más que un ejercicio escolar bastante elemental. Analizar sintácticamente una oración (sujeto, predicado, complemento directo, etc.) es dibujar un árbol. Una gramática de adjunción de árboles usa exactamente esto, guarda un catálogo de árboles sintácticos ya definidos y los ensambla de dos maneras: encajando un árbol en un hueco de otro, o insertándolo en medio de otro. Como cada árbol trae su palabra pegada, sabemos cuántas sílabas aporta antes de construir nada. En lugar de generar millones de frases y quedarnos con las que midan ocho, generamos directamente versos octosílabos ajustando el LTAG.

Contar sílabas sin contar sílabas
Para generar octosílabos primero hay que saber contar sílabas, y es aquí donde nos encontramos una grata sorpresa. En la escuela todos aprendimos a medir versos separando sílabas, con sus reglas de diptongos, hiatos y grupos consonánticos. Pues bien, en realidad, no hace falta separar nada.
Si, en lugar de operar con las letras, trabajamos con los fonemas, con los sonidos, nos percataremos de que toda sílaba del español tiene exactamente un núcleo, y ese núcleo es concretamente una vocal. Nunca una consonante, nunca la parte débil de un diptongo (semiconsonante o semivocal). Por lo tanto, el número de sílabas de una palabra es, sin más, el número de vocales de su transcripción fonémica. Da igual dónde caigan las fronteras silábicas, porque hay tantas sílabas como núcleos. El listado completo cabe en un folio. El español peninsular tiene diecinueve consonantes y cinco vocales, y son estas cinco, ni una más, las que pueden sostener una sílaba. Existen dos semivocales que se apoyan en la i y en la u, pero estas no cuentan.

Escribimos |v| para ese recuento de vocales del verso v. Sobre él solo hay que aplicar dos correcciones. La primera podríamos considerarla la costura invisible del verso, es lo que se conoce como la sinalefa. La segunda es la conocida ley del acento final.
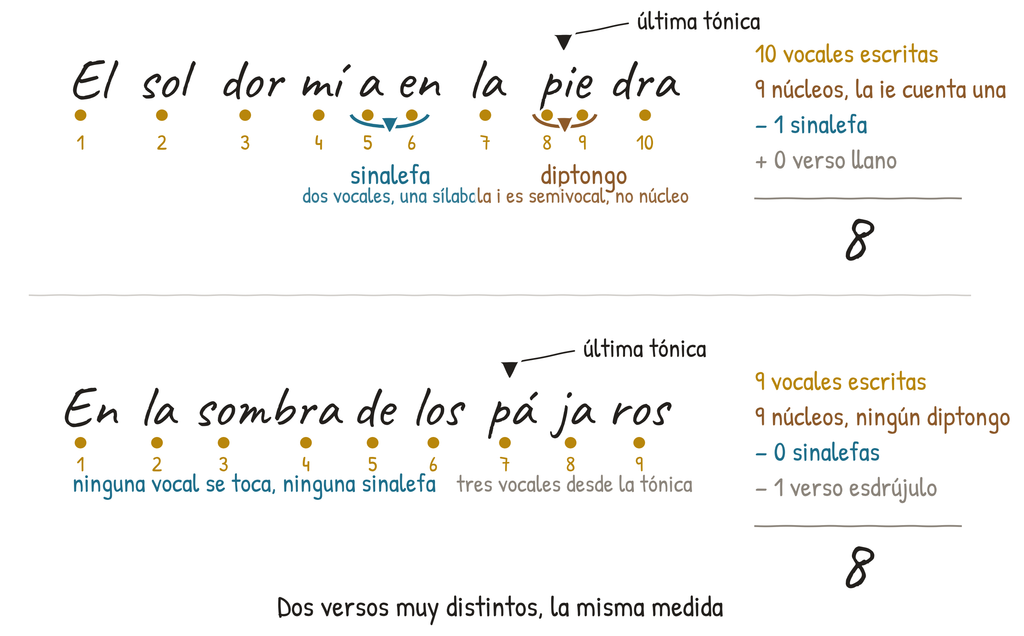
Vamos con la primera. Lea usted en voz alta el siguiente octosílabo:

Cuente ahora las vocales. Hay nueve, por lo que |v|=9. El verso, sin embargo, mide ocho, y cualquier hablante de español lo recita como octosílabo sin dudarlo un instante. Lo que sucede es que “dormía” y “en” se han fundido, la a final y la e inicial se pronuncian en un solo golpe de voz. Es la sinalefa, unión de vocales, y no es una excepción rara, sino la norma del verso castellano. Ocurre porque la métrica mide lo que suena, no lo que se escribe.
La formalización matemáticamente es sorprendentemente sencilla. Si el verso v está formado por las palabras p[1], p[2],…, p[k], basta contar en cuántas de sus fronteras se tocan dos vocales y restarlo del recuento bruto. Lo denotamos por sinalefa(v), la cual tiene por expresión matemática:

Llamamos corregido(v) al resultado de restar la sinalefa al número de vocales en el verso v, es decir,

Vamos con la segunda corrección. La métrica española cuenta hasta la última sílaba tónica y ajusta dependiendo de si el verso es agudo, llano y esdrújulo. Si denotamos por finales(v) al número de vocales que hay desde la última tónica hasta el final del verso (uno en los agudos, dos en los llanos y tres en los esdrújulos) la medida completa queda así:

Un verso es octosílabo si métrica(v)=8. Nada más.
Trabajar con sonidos y no con letras tiene además otros incentivos, y es que las excepciones ortográficas se esfuman. La h muda no hay que saltársela, porque sencillamente no existe como fonema, de modo que “la hora” produce su sinalefa sola. La conjunción “y” se pronuncia como una vocal, así que “tierra y aire” genera sus dos sinalefas. La diéresis tampoco requiere una regla específica: en “guerra”, la “u” no tiene realización fonética, mientras que en “güera” sí se pronuncia, y esa diferencia queda recogida directamente en la representación sonora. También ocurre que “la hierba” no hace sinalefa, que es lo correcto, porque esa “i” es una semivocal y no un núcleo. Una regla ortográfica del tipo “ignora la hache inicial” o “trata de forma especial la diéresis” tendría que acumular excepciones; la fonología no.
La rima es una relación de equivalencia
Instintivamente concebimos la rima como una relación entre dos versos. Cojo dos finales, los comparo y decido si riman. Es la forma natural de pensarlo y es la forma catastrófica de programarlo, porque con diez mil versos habría que examinar cien millones de parejas.
La alternativa consiste en darle la vuelta. En lugar de comparar, etiquetar. A cada final de verso le asignamos una clave, que en el caso de la asonancia es la sucesión de vocales desde la tónica, una vez aplicadas las tres reglas clásicas (Navarro Tomás 1956). La vocal débil del diptongo no cuenta, en las esdrújulas la vocal intermedia tampoco, y las vocales cerradas átonas finales se neutralizan. Así, viento, cielo y pleito reciben todas la etiqueta e-o, mientras que pájaro y árbol reciben la etiqueta a-o.
Por lo tanto, la rima deja de ser algo que haya que comprobar, es algo que cada verso lleva consigo:

Toda relación definida por igualdad de etiquetas es automáticamente una relación de equivalencia matemática. Toda relación de equivalencia divide un conjunto en clases disjuntas. En otras palabras, el corpus queda repartido en cajones de rima. Comprobar si dos versos riman ya no exige compararlos, basta con mirar en qué cajón está cada uno. El coste pasa de crecer con el cuadrado del número de versos a crecer linealmente, y ese detalle es la diferencia entre el modelo que cabe en un ordenador y el que no.
El modelo: un viaje entre versos
Con las piezas sobre la mesa, toca decidir cómo ensamblarlas. Y aquí hay una observación fundamental. En un poema, el sentido no está solo en los versos, sino en su sucesión. Un mismo verso puede adquirir significados muy distintos según cuál lo preceda. Por eso, más que la posición que ocupa cada verso, importa a qué otro verso sigue. Planteado así, el problema empieza a parecerse mucho a un viaje.
En nuestro experimento consideramos que un poema es una ruta por el corpus: cada verso es una parada y escribirlo consiste en elegir diez de ellas. Ese viaje tiene nombre y es uno de los problemas más conocidos de toda la Investigación Operativa: el Problema del Viajante de Comercio, conocido como TSP por sus siglas en inglés (The Traveling Salesman Problem). El enunciado de este problema es el siguiente: dadas unas ciudades y las distancias entre ellas, encuentre la ruta más corta que las visite todas y vuelva al punto de partida. Este es, literalmente, el problema que se te plantea un día que quieres visitar muchos monumentos durante un viaje. La misma idea puede llevarse mucho más lejos. Una de nuestras aplicaciones favoritas del TSP es usarlo para la ruta más corta que visita 1,3 mil millones estrellas del catálogo del telescopio Gaia (University of Waterloo, 2024).
Nuestro poema es ese mismo problema con tres retoques. No visitamos todas las ciudades, sino que elegimos diez de entre diez mil, de modo que qué paradas entran en la ruta forma parte de la decisión. No cerramos el circuito, porque el viajante vuelve a casa y un poema no, tiene un primer verso, que no sigue a nadie, y un último, al que no sigue nadie. Y en lugar de minimizar, maximizamos, porque nuestra distancia entre dos versos no es un coste que evitar sino una afinidad que buscar.
Además, debemos de incorporar ciertas prohibiciones sobre el camino: una parada par no puede ir seguida de otra par, ni una impar de otra impar. La rima se impone entonces en las paradas pares eligiendo una única clase de asonancia para todo el poema, y se permite libertad absoluta en los versos impares. De la métrica no hay que decir nada, porque todos los versos del corpus miden ya ocho sílabas, la métrica es una propiedad de las piezas, no del ensamblaje.
Queda decidir qué criterio guía la ruta, es decir, qué vamos a llamar calidad. Nuestro criterio es la coherencia local, que cada verso sea una continuación verosímil del anterior. Para medirla usamos los conocidos como embeddings, representaciones que convierten cada texto en un vector de números de modo que las expresiones de significado próximo caigan cerca en ese espacio. La idea de fondo es que dos palabras que aparecen sistemáticamente en los mismos contextos tienden a significar cosas parecidas.
Dos matices que aprendimos a base de malos resultados. El primero es que entre versos de ocho sílabas, el par más coherente según nuestra definición de afinidad acaba siendo casi siempre el que repite una palabra, por lo que hay que penalizar el solapamiento léxico. El segundo matiz es de tamaño, considerar todos los tramos posibles son cien millones de arcos, inasumible. Cada verso conserva solo sus treinta mejores vecinos según las puntuaciones de los embeddings, poda con la cual el mapa de carreteras reduce considerablemente el número tramos. El problema pasa de imposible a resoluble mediante un solver comercial, Gurobi en nuestro caso, en cuestión de segundos.

¿Es esto poesía?
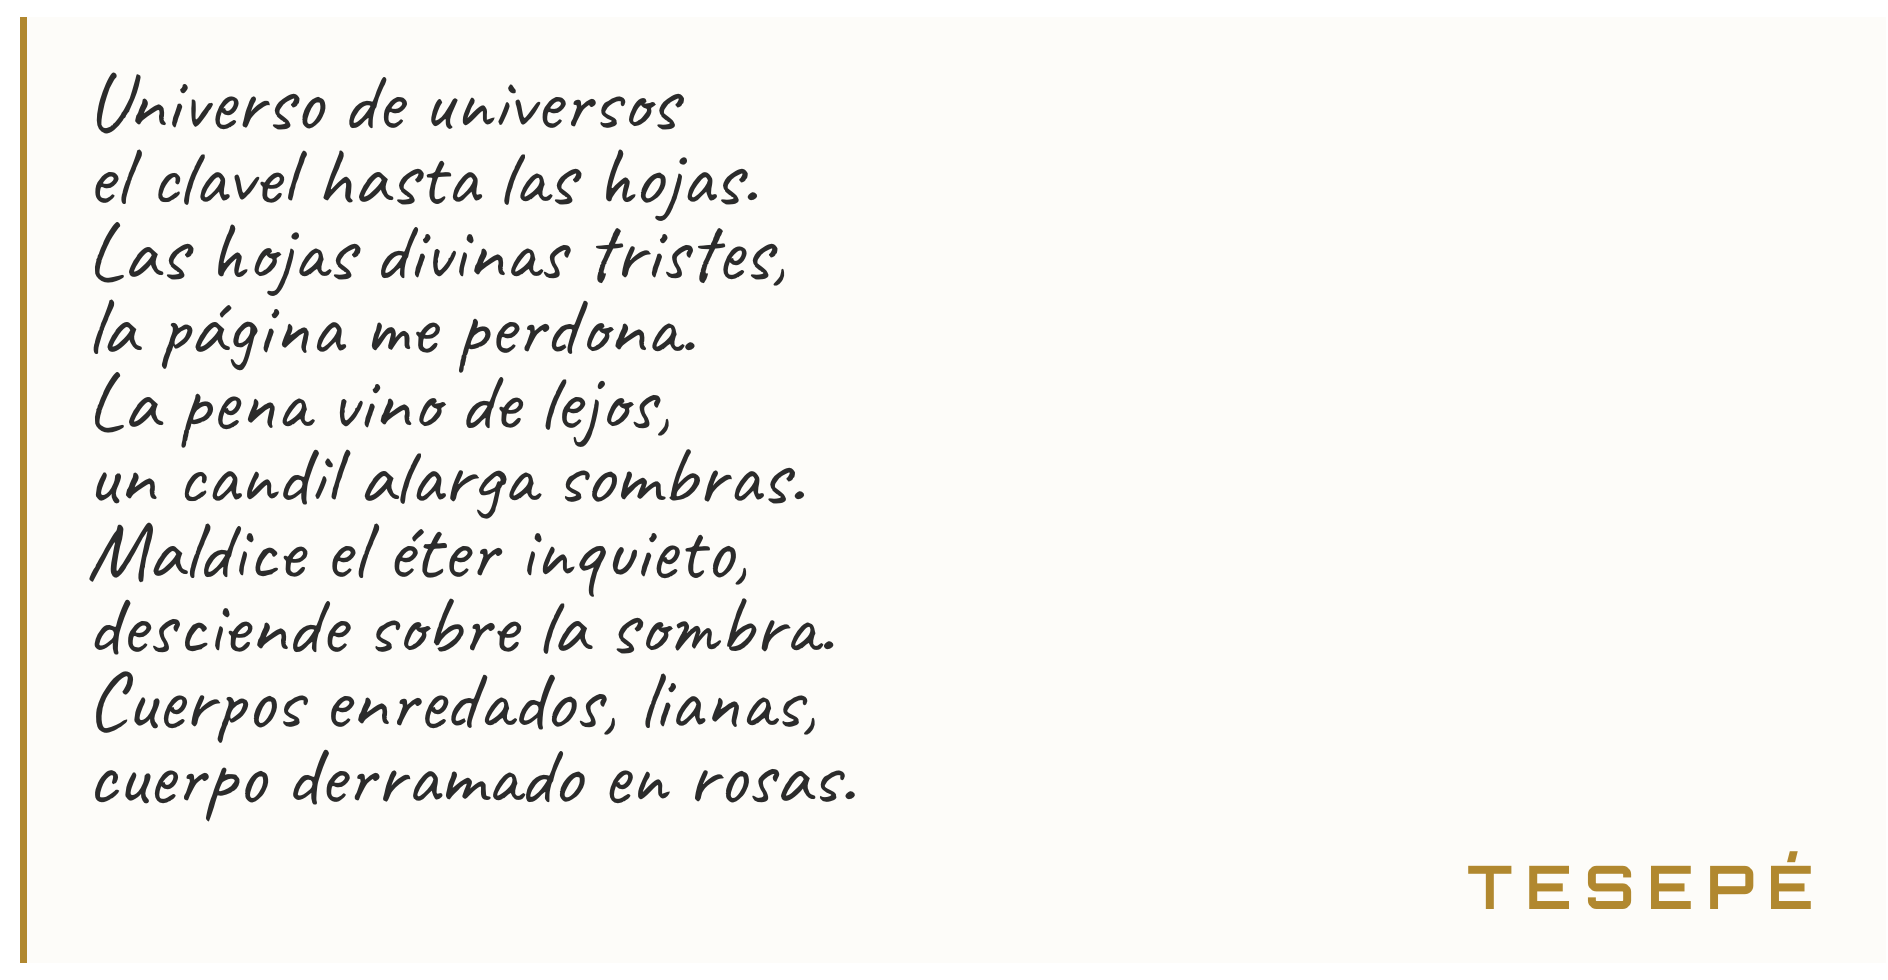
Llega, por fin, lo que todos estábamos esperando. De hecho, ya habéis tenido ocasión de leer uno de los poemas generados mediante este procedimiento, el que daba pie a este artículo. Lo firmaba TESEPÉ, que viene de como pronunciaría usted las siglas del problema que hay detrás del modelo, el TSP.

Los versos miden ocho sílabas, y eso es un dato verificable. Riman en asonante, y eso es verificable. Ninguna palabra final se repite, y eso también es verificable. Son las tres condiciones que garantiza el modelo, y las garantiza siempre. Además, el problema parece ser coherente. Y, con todo, tan solo aquello que no puede asegurar es lo que verdaderamente importa, ¿es poesía?
Porque el modelo no siente, no recuerda, no ha perdido a nadie. Lo que hace es navegar un espacio descomunal y quedarse con la combinación que mejor satisface un criterio que nosotros, humanos, hemos elegido. Si el poema conmueve, el mérito es del criterio y de quien escribió los versos de partida; si no conmueve, la responsabilidad ha de recaer en el mismo individuo. Basta con modificar el corpus para que cambie todo el resultado. El modelo es fiel al conjunto de datos que le proporcionamos, y solo a eso.
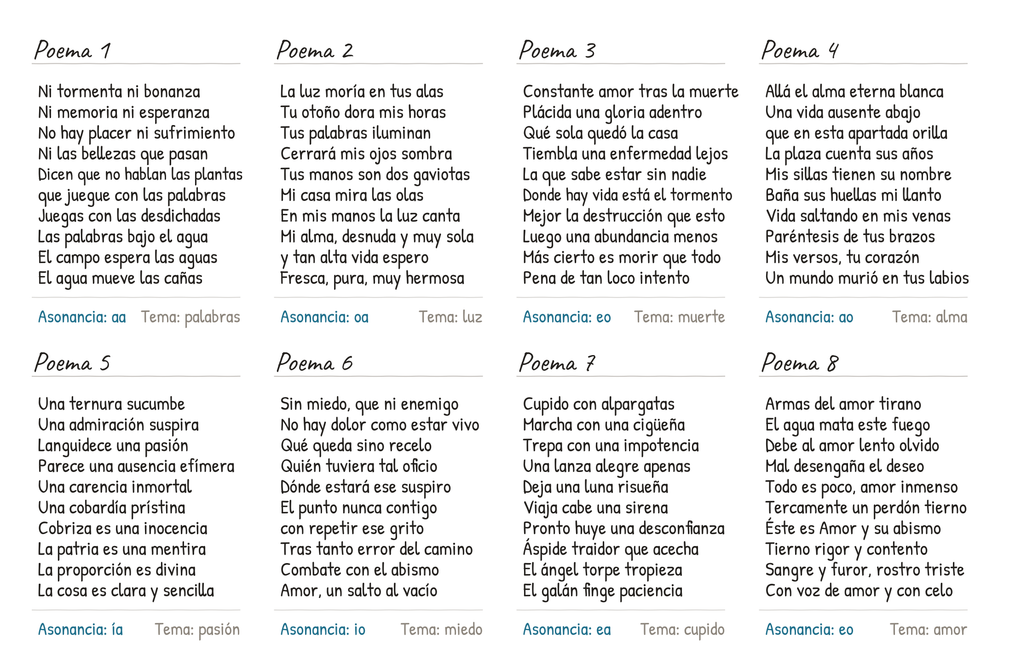
Os dejamos, para terminar, ocho romances construidos mediante el muestreo de versos candidatos de nuestro corpus, maximizando además de la afinidad diversos temas.
El sentido lo pone usted
El matemático Ron Aharoni escribió el libro Mathematics, Poetry and Beauty (Aharoni 2014), en el que se cuestionaba por qué un teorema y un poema producen la misma clase de placer. Su respuesta es que comparten mecanismos. La compresión, que consiste en decir mucho con muy poco. La sorpresa, que consiste en llegar donde no se esperaba. Y la estructura oculta que de pronto se revela y reordena hacia atrás todo lo que ya habíamos leído.
Vale la pena leerlo, porque deja clara una cosa que este artículo podría hacer olvidar. Nosotros hemos formalizado el andamio. Las sílabas, las rimas, las posiciones. Lo que ha de colocarse sobre este armazón, la imagen que no se le había ocurrido a nadie o el verso que cambia de sentido en el siguiente, eso sigue siendo enormemente difícil. Generar poesía es un problema de significado.
Alguna gente lleva décadas tratando de dilucidar estas cuestiones en la poesía computacional, y muchos de ellos en español. Pablo Gervás y su grupo en la Universidad Complutense han estado construyendo generadores de poesía castellana desde finales de los noventa, primero con sistemas expertos que codificaban explícitamente el saber métrico (Gervás 2001) y después con razonamiento basado en casos, es decir, componiendo a partir del recuerdo de poemas anteriores (Gervás 2013). Borja Navarro-Colorado ha trabajado el problema de escandir (contabilizar un verso dividiéndolo en sus sílabas métricas) poesía del Siglo de Oro (Navarro-Colorado 2018). En la UNED, el proyecto POSTDATA ha producido herramientas abiertas de análisis métrico (Rosa et al. 2020). Y en el País Vasco, el grupo HiTZ ha explorado formas de controlar la métrica y la rima de un modelo de lenguaje neuronal para el español y el euskera (Ormazabal et al. 2022). Así que, ya puestos, lanzamos el guante y animamos a que estos investigadores e investigadoras nos comuniquen sus impresiones al respecto, para lo cual ponemos a su disposición los diversos espacios de divulgación de la SEIO.
Antes de despedirnos, volvamos un momento a los diez versos del principio. Cuando los leyó no sabía de dónde venían, y aun así hizo con ellos lo que se hace con un poema. Buscó una imagen detrás del clavel y de las hojas. Decidió si una página que perdona le decía algo o no le decía nada. Puso una cara, un recuerdo, un tono de voz. Nada de eso estaba en el modelo, que se limitó a garantizar ocho sílabas, una asonancia sostenida y una cadena de versos que no se contradijesen demasiado. Todo lo demás corría de su cuenta, ávido lector.