

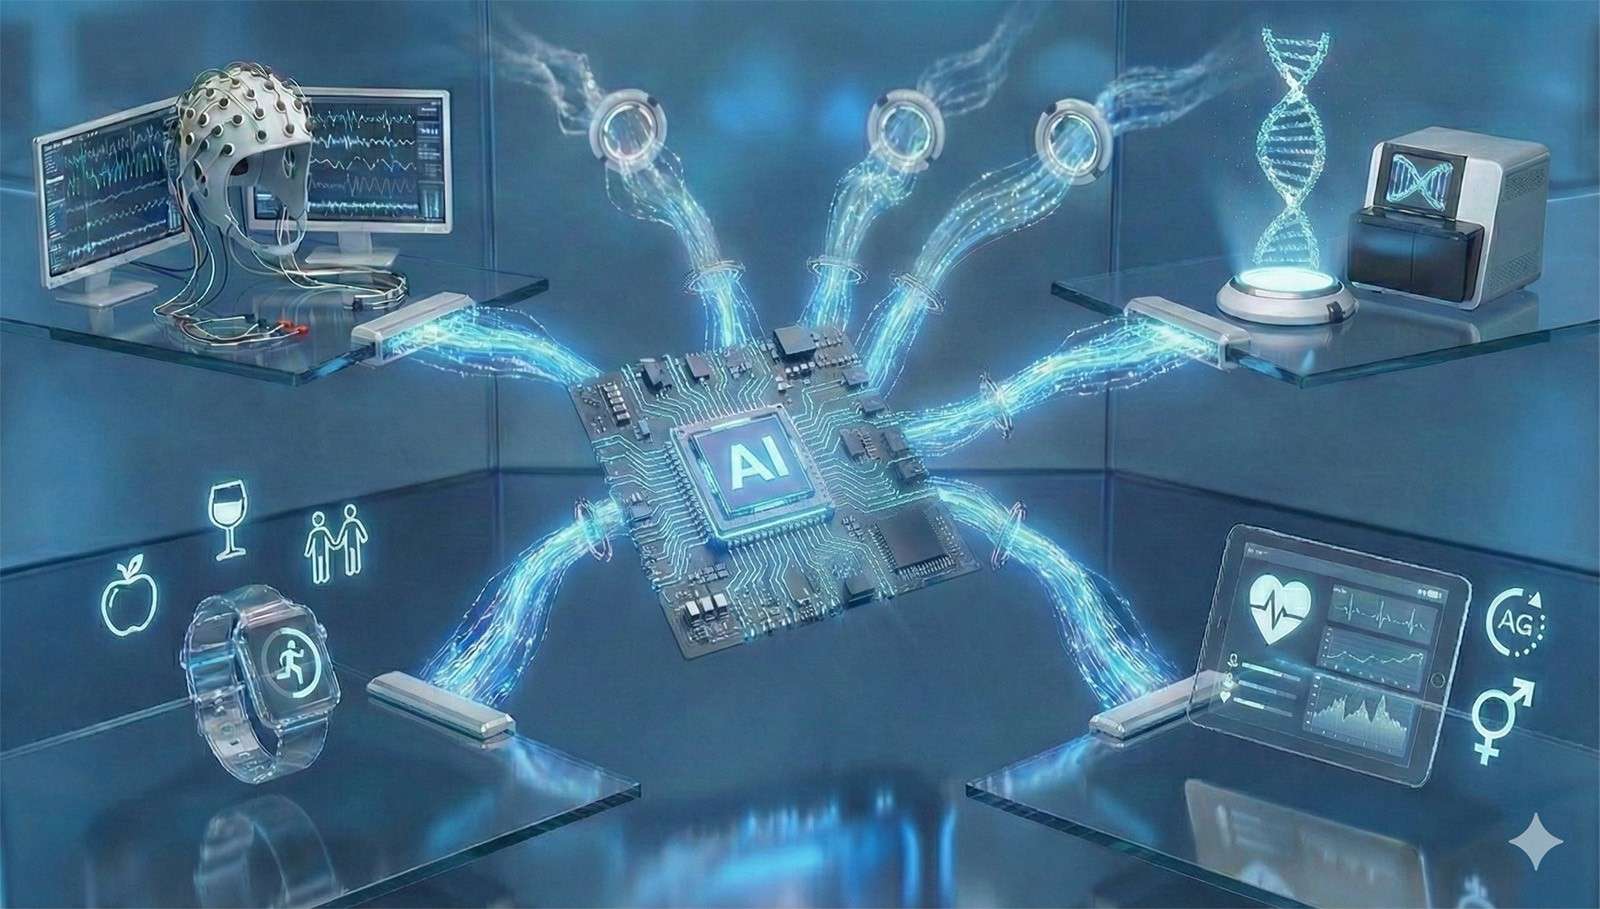


Comprender cómo se originan y cómo evolucionan las enfermedades que afectan al sistema nervioso central es uno de los grandes retos actuales en neurociencia. La pieza central de este desafío es el cerebro: un órgano extraordinariamente complejo, con una estructura y organización intrincadas, cuyo funcionamiento emerge de la interacción simultánea de múltiples elementos. Para predecir, diagnosticar y monitorizar la evolución de las enfermedades que le pueden afectar no es suficiente con observar una sola pieza del puzle, sino que es necesario integrar diferentes tipos de datos y entender sus relaciones. Sólo así es posible avanzar hacia modelos diagnósticos y pronósticos más precisos y útiles en la práctica clínica.
A la hora de analizar el sistema nervioso central, más concretamente el cerebro, podemos considerar dos niveles de análisis: estructura y funcionalidad. La estructura se refiere al tejido cerebral en forma de neuronas (especializadas en la transmisión de impulsos eléctricos) y células gliales (que complementan a las neuronas proporcionándolas soporte, protección e integridad); cómo está estructurado en materia blanca (donde encontramos los axones de las neuronas, zonas donde se transmiten señales eléctricas y se transporta la información) y materia gris (tejido donde podemos encontrar los cuerpos y dendritas de las neuronas, y donde se procesa la información); o cómo las diferentes regiones cerebrales (frontal, central, temporal, parietal y occipital) están conectadas entre sí. Por otra parte, la funcionalidad cerebral incluye la ejecución y regulación de los procesos asociados a la recepción y procesamiento de información sensorial, la generación de respuestas y el control de las funciones superiores como el pensamiento, las emociones, el aprendizaje o la memoria.
Adicionalmente, existen otros factores que pueden influir en el desarrollo de patologías neurológicas o proporcionar un efecto protector frente a ellas. Es común, en este sentido, abordar el efecto de la genética en el desarrollo de estas enfermedades. Todos nacemos con una determinada configuración genética, recogida en las cadenas de ácido desoxirribonucleico (ADN) a través de pares de bases nitrogenadas (adenina, guanina, timina y citosina). Cuando la combinación que los codifica se da de forma mayoritaria, hablamos del wild type de los genes, y no ejerce ningún efecto en nuestra salud. Sin embargo, cuando alguna base nitrogenada cambia respecto al wild type se habla de mutación. Y son estas mutaciones las que nos confieren factores de riesgo o protectores frente a diversas patologías. Además de la genética, existen otros factores que pueden influir en el desarrollo de patologías que afectan al sistema nervioso central, los cuales dependen en gran medida de nuestros hábitos diarios. Así, la dieta que seguimos, la cantidad de ejercicio físico que hacemos, la capacidad de socialización o el nivel educativo son claves. Pero también la exposición a la contaminación o la ingesta frecuente de alcohol y tabaco pueden influir. Por último, la presencia de otras patologías puede jugar un papel relevante: problemas cardiovasculares, diabetes y traumatismos craneoencefálicos producidos por accidentes de tráfico proporcionan un mayor riesgo de sufrir patologías neurológicas.
Como se desprende de las ideas anteriores, es necesario considerar diversas fuentes de datos para avanzar en la comprensión de las enfermedades que afectan al sistema nervioso central. Sin embargo, el análisis conjunto de todas estas fuentes de datos es complicado. Por una parte, se deben recoger todos estos datos de los pacientes, tarea costosa y que generalmente no es posible llevar a cabo en entornos clínicos debido a la falta de recursos. Por otro lado, todos estos datos deben ser procesados, analizados y presentados de manera intuitiva, tarea que requiere de equipos de computación potentes y nuevas técnicas de integración de datos biomédicos. En este sentido, las técnicas de inteligencia artificial (IA) pueden ser empleadas para generar herramientas sumamente útiles para llevar a cabo esta tarea.
La Imagen 1 muestra un esquema de cómo un modelo de IA puede ser empleado para analizar el conjunto de datos biomédicos asociados a un paciente. Generalmente, en este tipo de problemas, los modelos de IA nos dan como resultado un valor, una clase para ser más exactos, que representa el estado del individuo analizado. En este sentido, el modelo nos puede decir si según los patrones que ha observado en los datos el paciente sufre de la enfermedad o está sano. Aunque es aquí donde surge otra problemática: si bien modelos más complejos proporcionan mayor precisión en el resultado, ¿cómo podemos saber las decisiones que ha tomado el modelo internamente para llegar a esa conclusión?

Es en este punto cuando cobran importancia una nueva familia de técnicas de IA, englobadas en el concepto de Inteligencia Artificial Explicable (en inglés, eXplainable Artificial Intelligence, XAI). Las metodologías XAI nos proporcionan una serie de herramientas para interpretar cómo a partir de los datos de entrada se ha realizado el proceso de toma de decisiones.
Caso práctico: demencia debida a la enfermedad de Alzheimer
A continuación, se presenta un ejemplo en el que se han integrado diversos datos biomédicos para construir modelos interpretables de ayuda al diagnóstico de la demencia debida a la enfermedad de Alzheimer (EA).
De los diversos datos biomédicos que se pueden utilizar, en nuestro caso hemos considerado inicialmente diferentes parámetros extraídos del electroencefalograma (EEG), esto es, del registro de los débiles campos eléctricos generados por el cerebro; estos parámetros permiten cuantificar y resumir diferentes propiedades del EEG, tales como su complejidad, la proporción de oscilaciones neuronales a diferentes frecuencias, o la relación estadística entre la actividad cerebral generada en las distintas regiones cerebrales (lo que conocemos como conectividad funcional).
Por otro lado, hemos incluido diferentes genes, como ApoE, el cual es considerado el mayor factor genético involucrado en el posible desarrollo de patologías neurodegenerativas como la demencia debida a la EA, llegando a incrementar el riesgo de padecerla hasta 16 veces.
Por último, se ha incluido información relativa a datos sociodemográficos (como el nivel educativo), hábitos modificables (como la dieta, el ejercicio físico, y el consumo de alcohol y tabaco) o la presencia de patologías previas (las cuales se ha observado que pueden influir en el desarrollo de la demencia por EA).
En total, se han considerado en torno a 200 características de diversos tipos que proporcionan una descripción exhaustiva de diferentes factores que pueden influir en el desarrollo de la demencia por EA. Sin embargo, considerar tanta información a la vez puede ser poco eficaz, ya que algunas variables pueden ser redundantes o no ser realmente útiles.
Para solucionar este problema, se aplicó el método Fast Correlation-Based Filter (FCBF), que permite seleccionar solo las variables más relevantes, descartando las redundantes. Este proceso se repitió muchas veces para estar seguros de elegir las variables más relevantes de forma consistente.
De forma adicional, el número de variables elegidas se limita para evitar que el modelo se ajuste en exceso a los datos disponibles y pierda capacidad para funcionar bien con nuevos casos. Gracias a esta reducción, los modelos obtenidos son más sencillos, robustos y fiables para su uso como herramientas de ayuda al diagnóstico.
Metodología basada en aprendizaje máquina para la categorización de sujetos
Una vez seleccionadas las características más relevantes y menos redundantes, el siguiente paso es escoger el método de clasificación para generar el modelo de ayuda al diagnóstico de la demencia por EA. Si bien existen diferentes opciones, las técnicas de aprendizaje máquina (en inglés machine learning, ML) destacan por presentar un buen equilibrio entre precisión en la clasificación e interpretabilidad, además de no requerir de una cantidad grande de datos ni de recursos de computación como otros modelos más complejos, como las redes neuronales. Concretamente, los métodos utilizados fueron: Support Vector Machines (SVM), Random Forest, Gradient Boosting, y eXtreme Gradient Boosting (XGBoost).
Mientras que SVM es un modelo más simple y directo, el funcionamiento de Random Forest, Gradient Boosting y XGBoost se basa en combinar muchos modelos pequeños para tomar una decisión en común. Mientras que Random Forest crea muchos modelos en paralelo para combinar sus resultados y obtener una respuesta conjunta más fiable, Gradient Boosting y XGBoost los van generando de forma progresiva, de manera que cada nuevo modelo aprende de los errores de los anteriores. Gracias a este tipo de estrategias, los métodos suelen ofrecer resultados más robustos y precisos.
Los métodos anteriores fueron empleados para generar diferentes modelos de ayuda al diagnóstico que imitaran un procedimiento de screening clínico. Es decir, se generaron estos modelos para diferenciar personas cognitivamente sanas y pacientes susceptibles de sufrir algún grado de demencia por EA. Como puede observarse en la Imagen 2, el modelo que mejores prestaciones produjo fue el basado en el método Gradient Boosting. Por tanto, dicho modelo fue empleado para la siguiente etapa del estudio.

Abriendo la caja negra: hacia modelos de ayuda al diagnóstico explicables
El mayor inconveniente al que nos enfrentamos al emplear modelos de IA, especialmente aquellos que presentan mayor complejidad, es que no es sencillo interpretar los resultados que proporcionan. Por ello, en los últimos años se han desarrollado diversas metodologías XAI, algoritmos que facilitan generar una explicación intuitiva del proceso de decisión. Concretamente, en este estudio hemos aplicado el algoritmo Shapley Additive exPlanations (SHAP), el cual asigna una puntuación a los parámetros de entrada en función de su relevancia en el proceso de decisión del modelo.
Además, algo muy interesante de SHAP es que nos proporciona diferentes tipos de representaciones, como las obtenidas en la Imagen 2. Estas se denominan summary plots, y son un resumen, un ranking de las variables de entrada en función de su relevancia para el modelo. Como puede observarse en la Imagen 3, que corresponde con la clasificación entre sujetos sanos y pacientes, las variables más relevantes son aquellos parámetros extraídos de la actividad EEG.
Pero no son los únicos, ya que el ejercicio físico, la ingesta de alcohol, o diferentes genes, como el ApoE, muestran una gran relevancia en la diferenciación entre sujetos sanos y pacientes. ¿Cómo interpretar estas gráficas?
De la siguiente manera: a la derecha vemos una barra de color que representa los valores de cada parámetro; cuanto mayor sea su valor, los puntos, que representan a los sujetos, serán de un color rosa claro. Sin embargo, sujetos con valores menores de dichos parámetros serán representados en azul. Por otro lado, en la parte inferior del gráfico, vemos un eje que muestra los valores SHAP: cuanto mayor sean, el modelo interpreta que dichos valores son más útiles para clasificar a esos sujetos dentro de la clase objetivo (en este caso, pacientes). Si esos valores SHAP son negativos, servirán para clasificar a dichos sujetos como la otra clase, es decir, sujetos sanos.
Por tanto, estas representaciones establecen la asociación entre el valor de los parámetros bajo estudio, y la puntuación asignada por el algoritmo SHAP para la toma de decisiones. Así, podemos establecer el impacto de dichas variables en la clasificación.

Cuando los modelos de IA generan confianza
En definitiva, la integración de datos biomédicos heterogéneos, en combinación con métodos de aprendizaje automático y técnicas XAI, proporciona nuevas herramientas para comprender mejor diferentes enfermedades que afectan al sistema nervioso central, como es el caso de la demencia debida a EA.
Más allá de ofrecer predicciones precisas, es posible plantear nuevos modelos interpretables de ayuda al diagnóstico o pronóstico, con capacidad de identificar qué factores son más relevantes en la toma de decisiones, generando confianza y facilitando su aplicación clínica.
Gracias a ello, se abre la posibilidad de planificar de manera más efectiva intervenciones terapéuticas, facilitar la tarea de los especialistas médicos, optimizar los recursos clínico-asistenciales y, por supuesto, aumentar la calidad de vida de los enfermos.


